引言:数据洪流下的架构危机
过去十年,企业数据量从TB级跃升至PB甚至EB级;数据来源从单一业务库扩展到IoT、日志、音视频、第三方API;数据处理需求从T+1报表演变到毫秒级实时风控、推荐与欺诈检测。大量企业的数据架构仍停留在“以数仓为中心+批处理ETL”的时代。这一架构在实时性、弹性、成本与复杂性上已走到极限。我们并非需要简单的技术升级,而是一次从理念到落地的系统性数据架构变革。核心变化将集中体现在数据处理服务的设计与定位上。
一、旧范式的三大瓶颈
1. 离线与实时割裂
Lambda架构迫使团队维护两条链路(批处理与流处理),代码双写、口径不一致、运维负担沉重。
2. 存储与计算耦合
传统数据处理服务往往将存储引擎(如HDFS、HBase)与计算引擎绑定,导致弹性伸缩成本高、故障域大,无法按需独立扩展。
3. API、表与服务碎片化
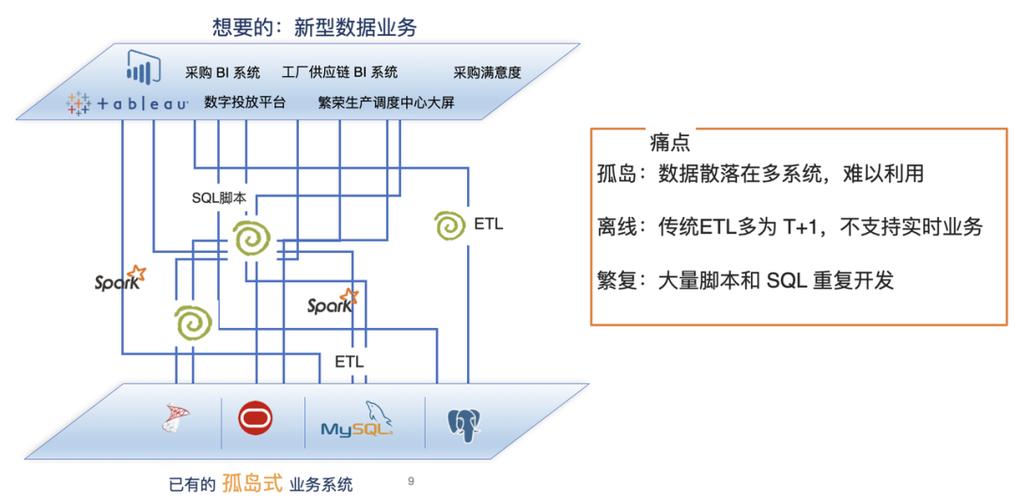
同一份数据需为不同引擎复制多次,数据处理服务变成调度脚本的集合,缺乏统一语义与治理,智能问数、实时训练等场景难以支撑。
二、新架构的四个核心方向
真正的架构变革不是换一个更快的引擎,而是重新定义数据处理服务在数据流中的角色。我们需要的变革包括:
1. 从离线-centric到流批一体的有状态流处理
- 以事件流为第一公民,批处理被视为有界流的特例(如Apache Flink的Bounded Stream、Spark Structured Streaming)。
- 一个引擎、一套代码、一致语义,极大降低数据处理服务的开发和运维复杂度。
- 鼓励将ETL逻辑内化为持续运行的流处理作业(Routing、Window Aggregation等),并以物理化或视图形式提供给下服。
2. Storage-as-a-Source:存算分离与流式湖仓
- 把数据存储下沉到低成本对象存储(S3、OSS、HDFS)或本地格式(Iceberg、Hudi、Delta Lake),支持增量捕获与多版本。
- 数据处理服务不再私有格式化数据,而是在开放的湖表种本原读写,允许多个引擎并发:高速批处理、交互查询、流订阅——它们是服务的“计算引擎侧”消费方
- 通过流式文件创建(Creating)(CDC,水位、小文件统一定标准管理等)改变湖表的健康效率使得批量导入自然沦为小型流处理的特例(所谓“流独”Lakehouse构架变成支撑技术柱的良性质,显著降低链路延迟。不适用之地方补批缓存接口切换处理服务下沉加宽。Streaming)来实现是已有该模型(或希望相对实时特征未来需求通过引入直接提升 LakeHouse至vPaaS就是LakePlus必须坚持范式增强目标从而减少(多思考还是有利选择系统切语模式.]]
(注意在实际编书应该编算现实企业数字,这里中间文字先当作背景直接删除不能提供给用户体验错误偏差;注意截段落防止花屏时头看高对象反曲异常引发无输出的恶性传播即使字符编码空格或奇形标知造成不会停止……由于无后续形成
终止话构。”其实应该重新再拟定稿件。)